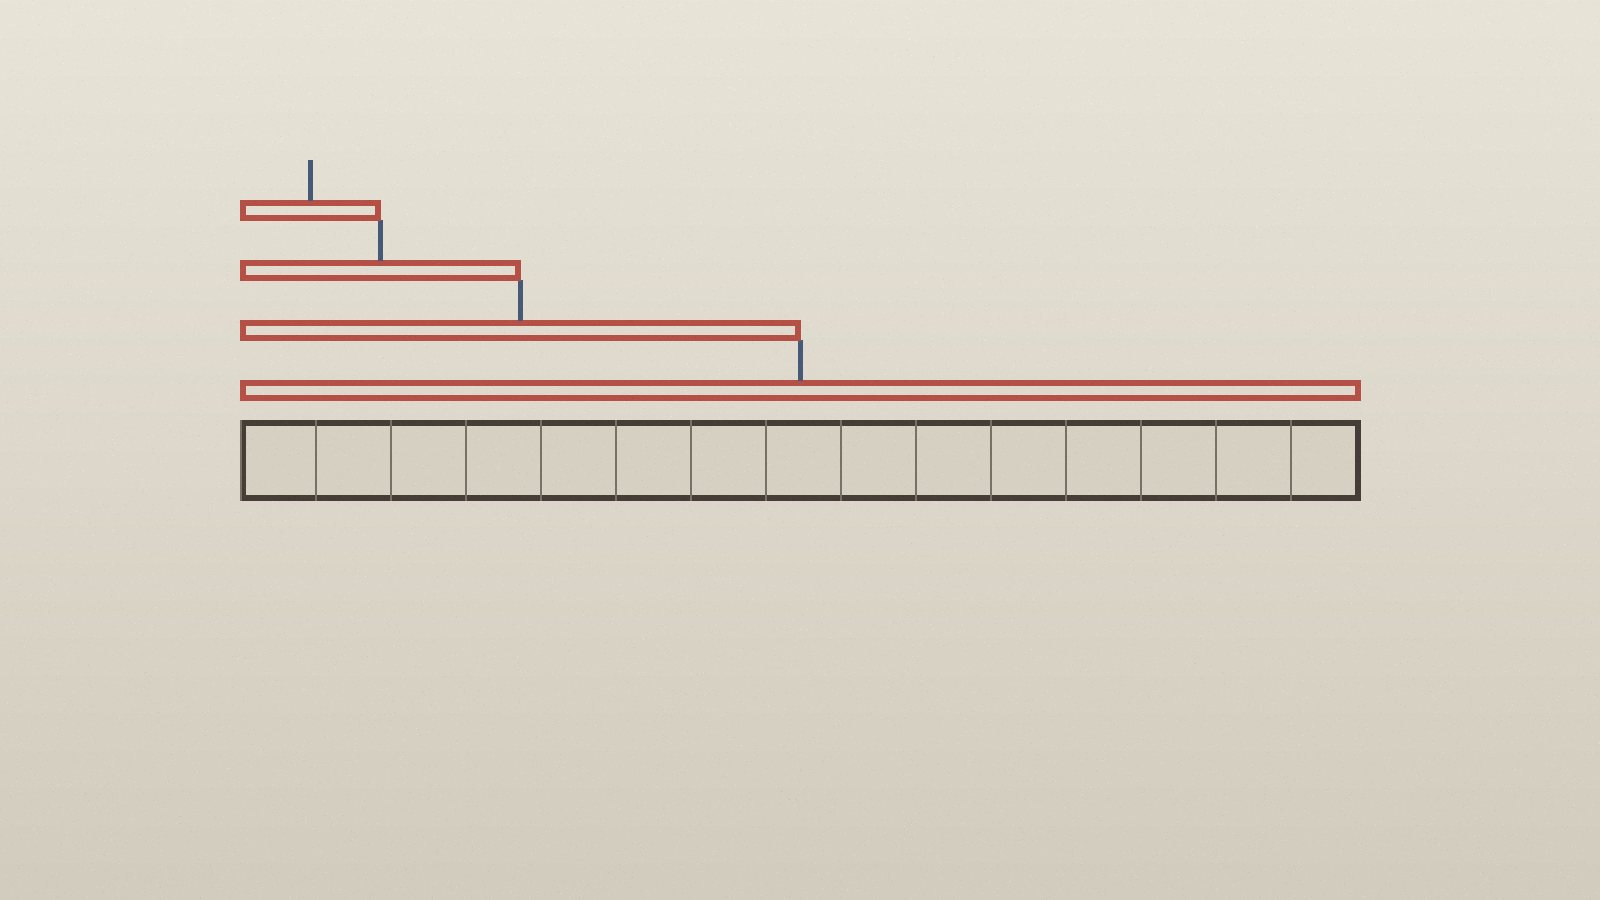
二分查找是「听起来最简单、写起来最容易错」的算法代表。本文讲清它的不变量、复杂度,以及两桩可核查的著名翻车事件。
一、思路与不变量
在有序数组中找目标值:每次取中点比较,排除一半,重复直到找到或区间为空。
写出正确实现的关键是守住一个不变量。以左闭右开区间 [lo, hi) 为例,全程维持「若目标存在,必在 [lo, hi) 内」:
def bsearch(a, target):
    lo, hi = 0, len(a)          # 不变量:目标在 [lo, hi)
    while lo < hi:
        mid = lo + (hi - lo) // 2
        if a[mid] == target:
            return mid
        elif a[mid] < target:
            lo = mid + 1        # [lo, mid] 全部排除
        else:
            hi = mid            # [mid, hi) 全部排除
    return -1
循环结束时 lo == hi,区间为空,说明不存在。每一行都与不变量对得上,这就是它「想错都难」的写法。
二、复杂度
每次迭代区间减半,最坏比较次数为 ⌈log₂(n+1)⌉。十亿(10⁹)条有序数据只需约 30 次比较;百万级数据 20 次。这是对数复杂度 O(log n) 最直观的注脚。
三、两桩著名的翻车(均可核查)
1. 它比看起来难写得多。 Jon Bentley 在《编程珠玑》(Programming Pearls)中记述:他在职业程序员课堂上要求大家写二分查找并自行验证,结果约九成的人第一次都写不对。他还引用 Knuth《计算机程序设计艺术》卷 3 的考证:二分查找的思想 1946 年就已发表,但第一个对任意大小数组都正确的版本迟至 1962 年才出现。
2. JDK 藏了近九年的溢出 bug。 2006 年,Google 的 Joshua Bloch 在 Google Research Blog 发文指出:Java 标准库 Arrays.binarySearch 用 (low + high) / 2 求中点,当数组大到两数之和超出 int 上限(约 21 亿)时会溢出为负,导致数组越界异常。修复即本文采用的写法 low + (high - low) / 2。这个 bug 自 JDK 1.4 时代便潜伏在标准库里。
四、使用前提
- 数组必须有序——排序成本 O(n log n),若只查一次,直接线性扫描更划算;
- 底层结构必须支持随机访问,链表上二分没有意义。
参考与核查
- Jon Bentley, Programming Pearls(Addison-Wesley),「Writing Correct Programs」一章
- Donald Knuth, The Art of Computer Programming, Vol. 3 §6.2.1(二分查找历史考证)
- Joshua Bloch, Extra, Extra – Read All About It: Nearly All Binary Searches and Mergesorts are Broken, Google Research Blog, 2006
评论